
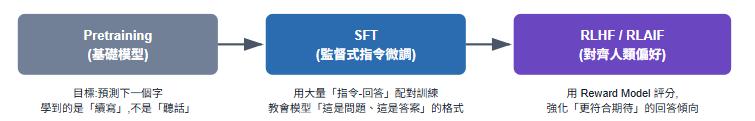
在一個模型被發布出來的時候,通常具備最強大能力的,反而是剛完成 Pretraining 的基礎模型(Base Model)。它能夠處理各種不同類型的任務,但同時也是最聽不懂人話的,甚至可以說它根本還不太理解人類現在是在問問題,還是在下指令。
如果你直接問一個純 Base Model:「請問台灣的首都是哪裡?」
它很可能不會直接回答你,而是接著寫:「這是一個很好的問題,很多學生也常常搞混……」
因為它學到的任務,是根據前面的文字,預測接下來合理的 token 是什麼,而不是理解「使用者正在提問」,並進一步回答這個問題。
所以當你丟給它一個指令時,它可能只是把這句話當成一段文字的開頭,然後根據自己在訓練過程中學到的語言模式,自顧自地繼續往下生成。
而要讓模型真正變成一個聽得懂指令的模型,第一步通常會進行 SFT(Supervised Fine-Tuning,監督式微調),它的核心做法,是準備大量指令 → 回答的配對資料,讓模型學習一個基本的互動模式:
> 使用者提出了什麼要求 → 一個好的助理應該如何回應。
> 請問台灣的首都是哪裡?→在台北市
> 請問台灣最好的大學是什麼?→台灣大學
接下來使用這些範例對模型進行進一步訓練,讓模型逐漸學會理解使用者的輸入是一個指令,並根據這個指令產生符合需求的回答,當然實際的資料並不會這麼簡單,它有可能是多輪的對話,甚至是一大串的system porompt與使用者輸入。例如:
System:
你是一個專業的客服助理。
回答使用者問題時,請保持禮貌,並使用繁體中文。
如果你不知道答案,不要自行猜測。

User:
我的訂單一直沒有收到,請問要怎麼辦?

Assistant:
很抱歉造成你的困擾。你可以先提供訂單編號,我可以協助你確認目前的訂單狀態。

User:
訂單編號是 A123456。

Assistant:
收到,請稍等,我幫你確認一下目前的訂單狀態。
在這筆資料中,模型學習的就不只是使用者問了什麼 → 助理回答什麼,而是同時學習 System、User、Assistant 不同角色之間的關係,以及在不同對話上下文中,助理應該如何延續前面的資訊產生下一個回答。
實際上的訓練資料甚至可能更加複雜,例如 System Prompt 裡面包含一大串行為規則,User 提供任務與額外資訊,前面還有多輪對話歷史,最後模型需要根據完整的 Context 產生下一個 Assistant 回覆:
System:
你是一個專業的旅遊助理。
- 使用繁體中文回答
- 回答需要簡潔
- 不可以捏造不存在的資訊
- 如果資訊不足,應該先向使用者詢問
- 如果使用者要求推薦,必須根據使用者提供的條件回答

User:
我下個月想去日本玩五天。

Assistant:
當然可以,你比較想去東京、大阪,還是其他城市?

User:
東京,我喜歡吃美食,也想逛一些景點。

Assistant:
了解,那我可以幫你安排一個以美食和景點為主的五天行程。

User:
那你幫我安排一下。

Assistant:
這時候真正需要模型學習的就是在這個 System Prompt 的規則下,理解前面的多輪對話,並根據目前 User 的要求,產生一個合理的 Assistant 回覆。因此 SFT 實際上是在大量這類型的範例中,逐漸讓模型建立起看到這樣的 Context,接下來應該如何回應的行為模式。
通過 SFT 之後,模型就不再只是單純地把輸入視為一段可以繼續往下生成的文字,而是開始學會區分使用者與助理的角色,以及理解指令與回答之間的關係。例如面對同一個問題,模型可能產生多種不同的回答方式,這時候單純知道哪個回答是正確的還不夠,我們還需要知道哪個回答更符合使用者的期待?
所以當模型完成 SFT 後,我們還需要進一步利用人類回饋等資料,讓模型學習如何產生更符合人類偏好的回答,而這個方式就叫做RLHF(Reinforcement Learning from Human Feedback,人類回饋強化學習)
整體來說RLHF 的概念可以分成幾個步驟,首先讓模型針對同一個問題產生多個不同的回答,接著再由人類標註者(或另一個模型,也就是 RLAIF)對這些回答進行比較與排序,標出哪些回答比較好、哪些比較差。並且在這過程中會訓練一個 Reward Model,讓它學習模擬人類的偏好與評分方式。最後再透過強化學習演算法,讓原本的模型根據 Reward Model 的評分持續調整,逐漸提高產生高分回答的機率。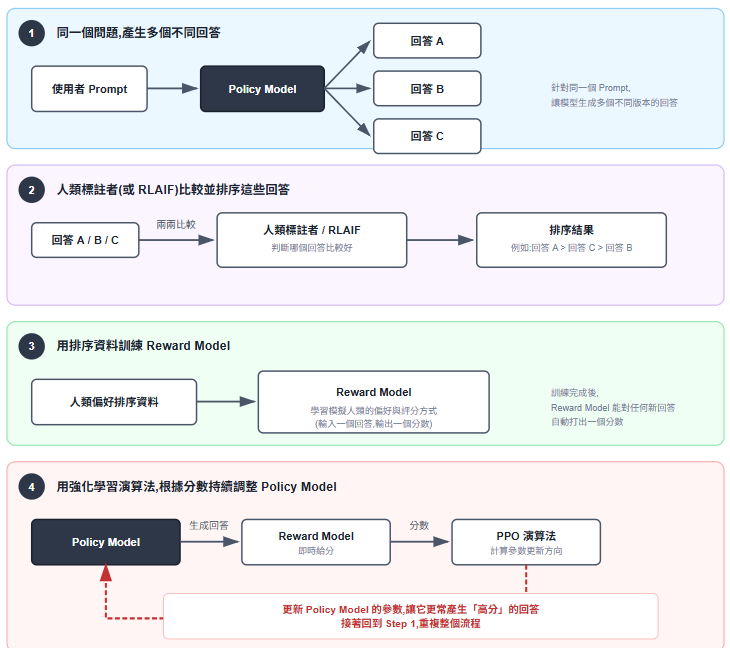
簡單來說就是讓模型的行為逐漸往人類偏好的方向靠近,讓它更符合人類真正想要的需求。
我們通過 SFT 進行訓練,讓模型更能理解所謂的 System Prompt,但實際上它更像是一份讓模型被訓練成傾向遵守的指示,而不是一條保證一定會被執行的程式規則,雖然經過 SFT + RLHF 訓練的模型,通常能夠很好地依照你的 System Prompt 行動,但當情境變得複雜模型的行為就可能開始偏移,無法完全按照你設定的規則執行,甚至發生錯誤。
這是因為訓練本質上建立的是一種統計上的行為傾向而不是強制性的規則,這也是我們 Day 4 講過的 Sampling。即使 RLHF 把模型調整得再好,最終輸出仍然需要經過 Sampling 這一關,因此依然存在產生不符合預期結果的可能性。
整個訓練或微調其實只是決定了模型傾向怎麼做,所以再次強調一點 Sampling 是最終決定了這一次實際選擇了什麼的方案,當兩者疊加起來,才形成模型最終的行為。
而在實際上我們還需要在架構層面加上額外的防線,例如讓 Reviewer Agent 專門檢查 Executor 的輸出是否偏離規則,再搭配 Day 4 提過的 Constrained Decoding,在關鍵的工具呼叫步驟直接限制輸出格式……等方法,這也是我們在使用這些模型時常常會生成到一半就會因為危險訊息、色情訊息...等中斷的原因之一。
到現在你已經知道模型是怎麼生成文字,以及模型該怎麼被訓練成聽得懂指令。而在明天我們要談的是 Hallucination(幻覺) 這一個部分,以及它背後的主因。到底為什麼模型有時候會用非常有自信的語氣,講出完全錯誤的內容?
而面對這個問題,我們可以想想前幾天的內容,想一下相關的解決方案又有哪些?那我們明天見!


 iThome鐵人賽
 看影片追技術